
Modelos de Machine Learning e suas aplicações
Machine Learning é um subconjunto da Inteligência Artificial que trabalha com dados e algoritmos para melhorar a capacidade da IA de imitar a forma como os humanos aprendem. Machine Learning se intersecta estreitamente com Deep Learning, seu subconjunto, que exploramos em outro artigo. Com o tempo, cientistas da computação podem treinar modelos de Machine Learning para aumentar sua precisão. Os algoritmos de Machine Learning formam a base dos sistemas de Machine Learning, que por sua vez determinam o tipo de modelo que produzem. Na vida cotidiana, Machine Learning produziu tecnologias de reconhecimento de fala, chatbots online e mecanismos de recomendação determinados algoritmicamente. O potencial do Machine Learning para moldar um novo paradigma de viver e trabalhar em uma sociedade tecnologicamente habilitada levanta questões éticas sobre privacidade, viés e responsabilidade, que exploraremos no artigo seguinte.
O que é Machine Learning?
Machine Learning é um subconjunto da IA e opera em um contexto mais restrito do que a IA geral. Por sua vez, Deep Learning é um subconjunto de Machine Learning. Como vemos em um artigo relacionado sobre Deep Learning, o que distingue Machine Learning e Deep Learning um do outro é que Deep Learning envolve pelo menos três camadas de redes neurais, que são Modelos de Machine Learning projetados para espelhar as vias neuronais do cérebro humano e os processos de tomada de decisão por predição.
Os algoritmos de Machine Learning consistem em três partes principais. Primeiramente, os algoritmos de Machine Learning recebem dados de entrada e escaneiam os padrões que eles formam para informar uma predição. Uma função de erro de um algoritmo de Machine Learning pode então comparar a predição que gerou com quaisquer exemplos conhecidos, avaliando assim a precisão do modelo. Finalmente, o algoritmo se ajusta aos pontos de dados no conjunto de treinamento, a fim de alinhar a predição do modelo mais estreitamente com o exemplo conhecido. Um ciclo iterativo pode então resultar desse processo inicial, produzindo uma otimização do modelo que alcançará incrementalmente um limiar de precisão. Consideraremos agora vários modelos de Machine Learning envolvidos neste processo de otimização de modelo:
1. Métodos de aprendizado supervisionado
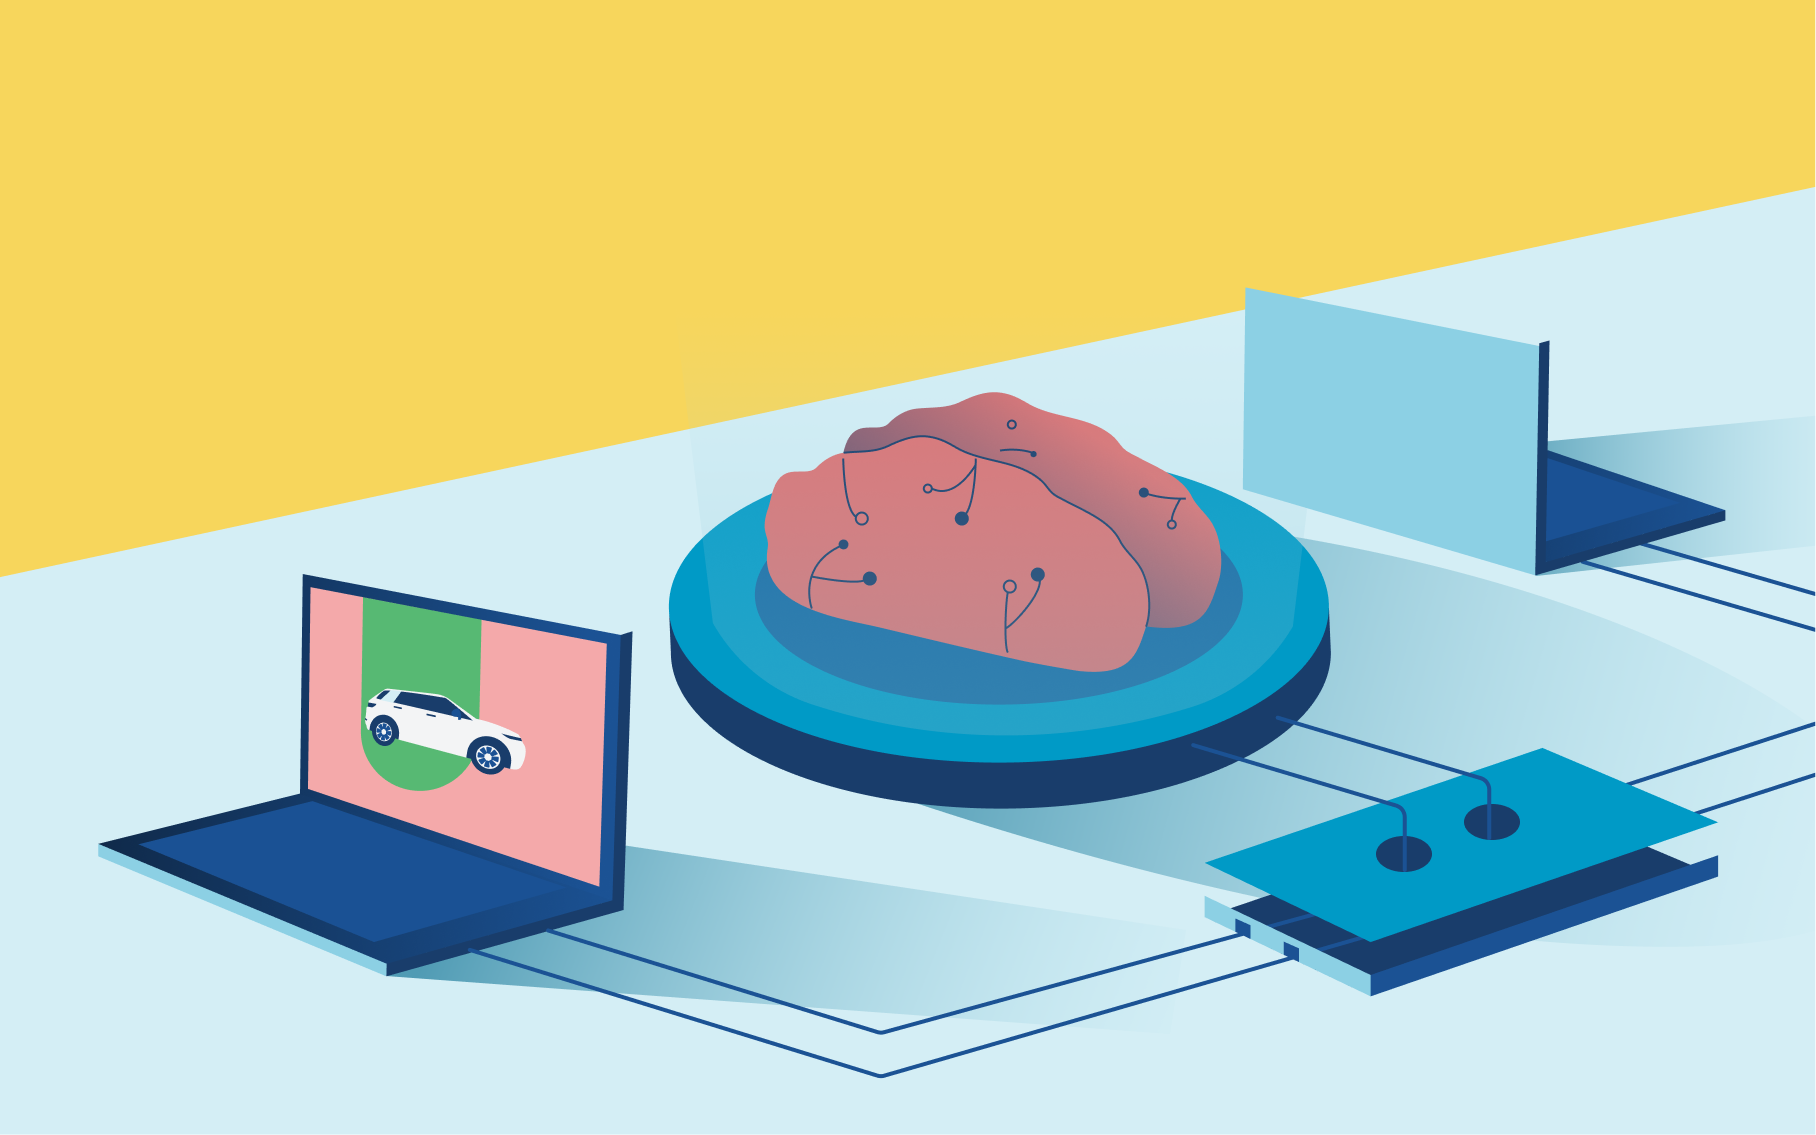
Os métodos de aprendizado supervisionado utilizam conjuntos de dados rotulados, que consistem em dados brutos atribuídos a rótulos para fornecer contexto, no processo de treinamento de algoritmos para classificar dados ou prever resultados. O modelo de aprendizado supervisionado recebe dados de entrada e ajusta seus pesos de acordo para se adequar aos dados. Nesta parte do processo, a etapa de ajuste é crucial para permitir que o modelo se ajuste aos dados sem se relacionar de forma muito estreita ou ampla com os dados e perder a capacidade de prever resultados com precisão. Ferramentas como classificação de spam em uma caixa de entrada de e-mail são um exemplo de aprendizado supervisionado. Os métodos de aprendizado supervisionado também podem envolver redes neurais. No caso da focalx, nosso software de escaneamento de veículos por IA melhora em precisão quanto mais dados de veículos entram no sistema, permitindo que os algoritmos ajustem suas capacidades de escaneamento exponencialmente.
2. Métodos de aprendizado não supervisionado
Os métodos de aprendizado não supervisionado espelham os métodos de aprendizado supervisionado na forma fundamental como treinam algoritmos para trabalhar em conjuntos de dados. A diferença com o aprendizado não supervisionado é que os dados com os quais trabalham não são rotulados e formam conjuntos de dados também conhecidos como clusters. No caso do aprendizado não supervisionado, os algoritmos expõem padrões ocultos ou clusters de dados, revelando semelhanças e diferenças nas informações. Como ferramenta, o aprendizado não supervisionado se presta bem à análise exploratória de dados (EDA), um método de pesquisa útil para testar hipóteses e identificar anomalias. Aqui, a análise de componentes principais (PCA) e a decomposição de valor singular (SVD) são técnicas comuns de EDA. Em um contexto de marketing, o aprendizado não supervisionado pode informar estratégias de venda cruzada e permitir a segmentação de clientes. Como os métodos de aprendizado supervisionado, os métodos de aprendizado não supervisionado podem envolver algoritmos como redes neurais, bem como métodos específicos de domínio, como algoritmos de agrupamento probabilístico.
3. Métodos de aprendizado semissupervisionado
Os métodos de aprendizado semissupervisionado são um híbrido de métodos de aprendizado supervisionado e não supervisionado. Os algoritmos de aprendizado semissupervisionado treinam conjuntos de dados rotulados menores para direcionar a classificação enquanto extraem de um conjunto de dados maior e não rotulado. Neste sentido, os métodos de aprendizado semissupervisionado podem equilibrar o viés nos rótulos que pode surgir nos métodos de aprendizado supervisionado, ao mesmo tempo em que priorizam o maior grau de precisão ao usar os resultados-alvo claros dos métodos de aprendizado supervisionado, em contraste com os métodos de aprendizado não supervisionado. Além disso, uma vantagem de priorizar métodos de aprendizado semissupervisionado é adaptar-se a contextos onde não existem dados rotulados suficientes para treinar algoritmos de aprendizado supervisionado. Como solução para economizar recursos quando a rotulagem de dados se torna custosa, os métodos de aprendizado semissupervisionado podem permitir a incorporação de IA em empresas e organizações menores.
4. Métodos de aprendizado por reforço
Os métodos de aprendizado por reforço estão intimamente conectados aos métodos de aprendizado supervisionado, sendo a diferença que os métodos de aprendizado por reforço não treinam algoritmos usando dados de amostra. Em vez disso, os modelos de aprendizado por reforço aprendem por tentativa e erro, gerando a melhor solução para um determinado problema após encontrar várias incompatibilidades ao longo do caminho. Um exemplo recente de aprendizado por reforço é na área de locomoção robótica, onde robôs humanoides seguem a direção de entradas de aprendizado por reforço, navegando com sucesso em ambientes internos e externos.
Aplicações comuns de Machine Learning na vida cotidiana
Aplicações comuns de Machine Learning na vida cotidiana estão em ambientes baseados em linguagem, onde modelos de linguagem podem transformar sinais de fala em comandos, incluindo em tecnologias de reconhecimento de fala como Siri, ou assistentes pessoais virtuais como Alexa da Amazon. Em ambos esses contextos, o processamento de linguagem natural (NLP) combina um modelo baseado em regras da linguagem humana com modelos de Machine Learning. Outro exemplo da vida real de Machine Learning é o uso de mecanismos de recomendação orientados por dados que descobrem o comportamento do consumidor para impulsionar modelos preditivos.
1. Tecnologias de reconhecimento de fala
O reconhecimento de fala, também conhecido como Reconhecimento Automático de Fala (ASR), fala-para-texto ou reconhecimento de fala por computador, aproveita as capacidades de NLP para transformar a fala humana em um formato escrito. Dispositivos móveis e tablets frequentemente incorporam ASR em seus sistemas, como Siri ou Google Assistant. As funções de ASR permitem melhor acessibilidade para mensagens de texto. No contexto da indústria automotiva, os reconhecedores de fala podem utilizar sistemas de navegação ativados por voz e capacidades de busca incorporadas em rádios de carros para melhorar a segurança do motorista.
2. Chatbots online e agentes virtuais
Chatbots online e agentes virtuais são outra aplicação cotidiana de Machine Learning. Em áreas de atendimento ao cliente, como bancos online, chatbots alimentados por IA podem sincronizar com sistemas de Gestão de Relacionamento com o Cliente (CRM). Aqui, esses chatbots podem integrar-se com plataformas de dados de clientes na predição de problemas comuns e fornecer aos clientes um serviço de assistência personalizada 24/7. Além disso, chatbots online servem profissionais de marketing na promoção de seus produtos através do engajamento do cliente em sites e plataformas de mídia social. Uma das funções mais úteis dos chatbots é que eles podem responder a FAQs (Perguntas Frequentes), fornecendo suporte relevante para clientes relacionado a conselhos, envio e outras recomendações de produtos relevantes. Ao treinar modelos de IA para trabalhar em conjuntos de dados de clientes, as empresas podem usar predição para melhorar a relevância e utilidade de suas mensagens para os clientes. Alguns dos bots de mensagens mais comuns incluem Slack ou Facebook Messenger. A IA conversacional, portanto, representa a fronteira de como a IA pode imitar a fala e a conversa humanas.
3. Mecanismos de recomendação orientados por dados do consumidor
Mecanismos de recomendação orientados por dados do consumidor são um meio útil de usar algoritmos de IA para identificar padrões em dados para melhorar estratégias de venda cruzada. Ao extrair dados que refletem o histórico do comportamento de um consumidor e sua interação com produtos, esses algoritmos podem fazer recomendações de produtos direcionadas para melhorar a experiência geral do cliente, promovendo lealdade e negócios repetidos. Um exemplo de tal ferramenta é Rosetta, uma ferramenta alimentada por IA que usa funções de predição de Machine Learning para transformar o engajamento do cliente. Neste exemplo, as marcas podem usar recomendações de eCommerce que Rosetta gera para entender melhor as necessidades dos clientes e melhorar a retenção. Finalmente, um exemplo comum de mecanismos de recomendação centrados no consumidor é a função de análise preditiva informada por dados da Amazon.
Ao aproveitar algoritmos de Machine Learning para fazer recomendações de produtos relevantes aos clientes no checkout, as abordagens de venda cruzada da Amazon visam clientes em um momento em que eles estarão mais propensos a considerar fazer uma compra adicional. De forma similar, os mecanismos de recomendação da Amazon lembram as compras passadas dos clientes, o que também melhora a qualidade da predição para recomendações de compras futuras.
Prós e contras do Machine Learning: novas oportunidades e impactos imprevistos
1. Interrupções no mercado de trabalho atual
Interrupções no mercado de trabalho atual é a área da IA que os críticos da IA mencionam em debates sobre os contras dos algoritmos de Machine Learning. Machine Learning já criou um novo paradigma para o trabalho, trazendo benefícios imprevistos da automação. Embora existam preocupações em relação à automação, essa interrupção cria novas avenidas de emprego. Um exemplo é a indústria automotiva, onde muitos fabricantes como a General Motors estão fazendo a transição para a produção de veículos elétricos para atender padrões mais ecológicos para metas de sustentabilidade.
À medida que os veículos fazem a transição de gasolina para eletricidade, há ampla oportunidade para a IA capacitar a transição para um novo paradigma. De forma similar, a IA criará uma demanda por empregos em outras áreas, incluindo a necessidade de mãos humanas para apoiar a gestão de sistemas complexos de IA. Além disso, a IA moldará a criação de novos empregos que abordam problemas técnicos emergentes relacionados às indústrias que ela afeta. O atendimento ao cliente é um exemplo de uma indústria onde a IA aproveitará Machine Learning para mudar a forma como as empresas atendem às necessidades de seus clientes, desde a promoção de produtos até permitir a lealdade e retenção do cliente. Nesta área, existe a possibilidade de as empresas usarem as capacidades da IA para automatizar campanhas de marketing de produtos e usar predição de dados para criar uma melhor experiência de produto.
No geral, o maior desafio de integrar a IA no mundo do trabalho será apoiar a transição das pessoas para novos papéis que estão em demanda devido ao impacto da IA nas mudanças de demanda da indústria.
2. Segurança de dados
Segurança de dados é outro aspecto do Machine Learning onde interrupções no paradigma atual de interação digital levaram a mudanças em políticas recentes. Um exemplo de mudança de política resultante é a legislação do Regulamento Geral de Proteção de Dados (GDPR) de 2016 para proteger os dados pessoais das pessoas dentro da União Europeia e Área Econômica Europeia. Além disso, no Estado da Califórnia, EUA, as autoridades introduziram uma lei de proteção de dados específica para consumidores, a Lei de Privacidade do Consumidor da Califórnia (CCPA). A CCPA exige que as empresas informem os consumidores sobre a coleta de dados de suas Informações Pessoalmente Identificáveis (PII).
Apesar dos contras de se adaptar a um novo paradigma, onde o impacto dos algoritmos de Machine Learning na proteção de dados e privacidade apresenta desafios complexos, existem prós para o surgimento da IA e Machine Learning nesta área. Por exemplo, embora a IA adicione uma camada de complexidade e vulnerabilidade aos modelos existentes de segurança de dados, existem igualmente várias oportunidades para usar algoritmos de IA e modelos de predição para resolver desafios de cibersegurança.
Quando usado habilmente, os algoritmos de Machine Learning podem resolver os mesmos desafios que eles apresentam à segurança. Embora cibercriminosos possam manipular o ChatGPT para seus próprios fins e interromper sistemas de negócios internos, desenvolvedores de IA, empresas e formuladores de políticas podem colaborar para treinar uma geração de novos profissionais de cibersegurança para melhorar a infraestrutura global de cibersegurança. Desta forma, um novo setor de funções dentro do setor de cibersegurança pode emergir e se tornar um caminho de carreira atraente para solucionadores de problemas, com uma escassez global estimada de 4 milhões de profissionais de cibersegurança.
De acordo com um artigo de 2023 do Fórum Econômico Mundial, o continente africano tem a maior demanda por treinamento para prevenir ameaças de crimes cibernéticos relacionados à IA. Esta estatística é importante porque reflete a importância da cibersegurança como uma questão global que tem implicações estruturais nas economias locais e internacionais em um mundo hiperconectado.
3. Viés, discriminação e áreas cinzentas éticas
Viés, discriminação e áreas cinzentas éticas são uma terceira preocupação relacionada ao uso generalizado de algoritmos de Machine Learning no mundo de hoje. A principal preocupação com a discriminação relacionada ao Machine Learning é que os modelos de Machine Learning podem herdar viés da influência humana e amplificá-lo em aspectos importantes da sociedade [1].
O viés é particularmente relevante na área de modelos de aprendizado supervisionado, onde profissionais de IA treinam modelos de Machine Learning usando conjuntos de dados rotulados, o que pressupõe um viés de seleção antes que os modelos tenham analisado os dados. Outro exemplo dos contras dos modelos de Machine Learning é em processos de contratação de recrutamento para corporações transnacionais. Um estudo mostrou que a Amazon teve que descartar uma ferramenta experimental de Machine Learning usada para filtrar currículos de candidatos e identificar os melhores talentos, pois a ferramenta se mostrou discriminatória, penalizando currículos que incluíam a palavra “mulheres”, como em frases como “capitã do clube de xadrez feminino”.
Além disso, os críticos apontaram ainda mais as águas turvas do uso de modelos de Machine Learning em práticas de contratação, incluindo a falta de política clara sobre quantos dados sobre um candidato uma organização pode acessar. Em outro contexto, a IBM descontinuou seus produtos de reconhecimento e análise facial à luz dos riscos de aplicações antiéticas de ferramentas de reconhecimento facial de IA para vigilância em massa e perfil racial que violam direitos humanos básicos.
Por outro lado, algumas organizações apoiam o argumento de que os modelos de Machine Learning permitem que seus recrutadores vão além das redes usuais de candidatos e atraiam um pool de talentos maior. Por exemplo, o Goldman Sachs criou uma ferramenta de análise de currículo para canalizar candidatos para a divisão onde eles seriam mais adequados.
Como é o caso dos desafios de segurança de dados que os algoritmos de Machine Learning apresentam, as funções potencialmente discriminatórias das práticas de contratação apoiadas por IA requerem uma colaboração entre formuladores de políticas, sistemas de gestão empresarial e pesquisadores para garantir que as práticas de contratação permaneçam o mais justas possível. De acordo com a Reuters, o cenário legal está se adaptando com nova legislação a esses desafios, incluindo a Lei de Responsabilidade Algorítmica dos EUA e a Lei de Inteligência Artificial na UE, fornecendo uma estrutura para garantir responsabilidade e neutralidade em todas as aplicações de IA.
Conclusão
Os Modelos de Machine Learning são um aspecto fundamental da Inteligência Artificial que pode revolucionar a forma como os humanos interagem na vida cotidiana, automatizando uma variedade de funções. Como exploramos neste artigo, os prós e contras dos algoritmos de Machine Learning interagem de forma complexa, o que significa que advogados, formuladores de políticas e organizações estão se adaptando rapidamente às áreas cinzentas éticas apresentadas por seu impacto em áreas-chave da vida, como o mercado de trabalho.
Nossa conclusão desta análise é que o impacto dos Modelos de Machine Learning e seus prós e contras para domínios humanos não se limita a uma área específica. Em vez disso, as implicações generalizadas dos modelos de Machine Learning para segurança de dados, oportunidades de força de trabalho, software de segurança para reconhecimento facial e algoritmos de mídia social significam que a ética e os valores da IA são um tópico essencial para discussão e colaboração. É, portanto, fundamental que eticistas, pesquisadores e especialistas jurídicos se unam para elaborar legislação adequada para regular as práticas de IA e aproveitar seus benefícios.