
A TI não bloqueou a implementação — o design ruim da implementação bloqueou
O design ruim da implementação, e não a resistência da TI, é geralmente o que bloqueia uma implantação, pois tenta resolver todas as dependências (hardware, integrações, parceiros, mudança de processos) antes de provar o valor nos pontos de entrega operacional onde as inspeções já ocorrem. Este artigo explica por que programas “big-bang” estagnam, como é um modelo de implantação em fases na logística de veículos acabados, o que a TI realmente precisa para aprovar e apoiar a escala, e como evitar a criação de novos silos de dados ao expandir da captura para fluxos de trabalho e integrações.
Explicação central: prove o valor nos fluxos de trabalho primeiro, depois escale a captura e as integrações
Implantações rápidas na logística de veículos funcionam quando seguem a sequência de como o trabalho acontece: a evidência é capturada nas mudanças de custódia, as decisões operacionais são tomadas no “meio confuso” das exceções e, só então, as empresas precisam de sincronização estruturada de sistemas de registro. Se você tentar começar com o design de integração total, instalação de hardware fixo e integração de múltiplos parceiros, a implementação assume um mundo perfeito: processos estáveis, dados consistentes, partes interessadas alinhadas e maturidade imediata de governança. Na prática, o caminho mais rápido é começar com a captura guiada por dispositivos móveis em momentos de inspeção inevitáveis, anexar a codificação de danos correta no ponto de captura e colocar uma camada de fluxo de trabalho para que as exceções sejam realmente assumidas, progredidas e encerradas. Uma vez que o registro do evento é consistentemente criado e encerrado, a escala para captura fixa e integrações de sistema torna-se uma etapa de implementação, em vez de uma aposta de transformação.
Por que o modelo big-bang falha em implementações de logística de veículos acabados
Os programas big-bang falham porque agrupam muitas incógnitas em um único marco de “entrada em operação”. Na logística de veículos acabados, as inspeções situam-se na interseção de várias partes (transportadoras, terminais, OEMs, pátios, última milha) e múltiplos sistemas (TMS, sistemas de pátio/terminal, ferramentas de sinistros, gestão de documentos). Quando uma implementação exige novo hardware em todos os lugares, que cada parceiro siga novos POPs e que cada sistema troque eventos perfeitamente estruturados desde o primeiro dia, o projeto torna-se frágil: uma dependência ausente interrompe o progresso, e um caminho de exceção fora do design corrói a confiança no resultado.
Observamos repetidamente que “a TI nos bloqueou” torna-se a explicação conveniente após a estagnação de um programa. Os projetos que morreram foram aqueles que tentaram integrar tudo primeiro: integração big-bang, novo hardware em cada local, todos os parceiros integrados e cada fluxo de trabalho redefinido antes que alguém tivesse demonstrado resultados tangíveis nas inspeções de mudança de custódia que não podem ser ignoradas. Se você quiser uma abordagem adjacente a isso, veja nosso artigo sobre como começar a obter visibilidade sem integrar toda a cadeia.
O big-bang também cria o que as operações mais tarde vivenciam como dívida de evidência: qualidade de captura inconsistente, registros de eventos fragmentados e falta de contexto que tornam a resolução posterior e o trabalho de sinistros mais lentos em vez de mais rápidos. Para leitores que buscam uma visão em estilo de checklist, também documentamos modos de falha comuns ao adotar inspeções por IA que frequentemente aparecem nesses designs de “tudo de uma vez”.
Modelo em fases: captura móvel guiada → captura fixa → integração
Um modelo em fases funciona porque alinha o investimento e a complexidade com o que já foi validado nas operações do dia a dia. O objetivo não é adiar a integração indefinidamente, mas tornar a integração previsível, padronizando primeiro o registro do evento e provando que as exceções podem ser encerradas com responsabilidade clara.
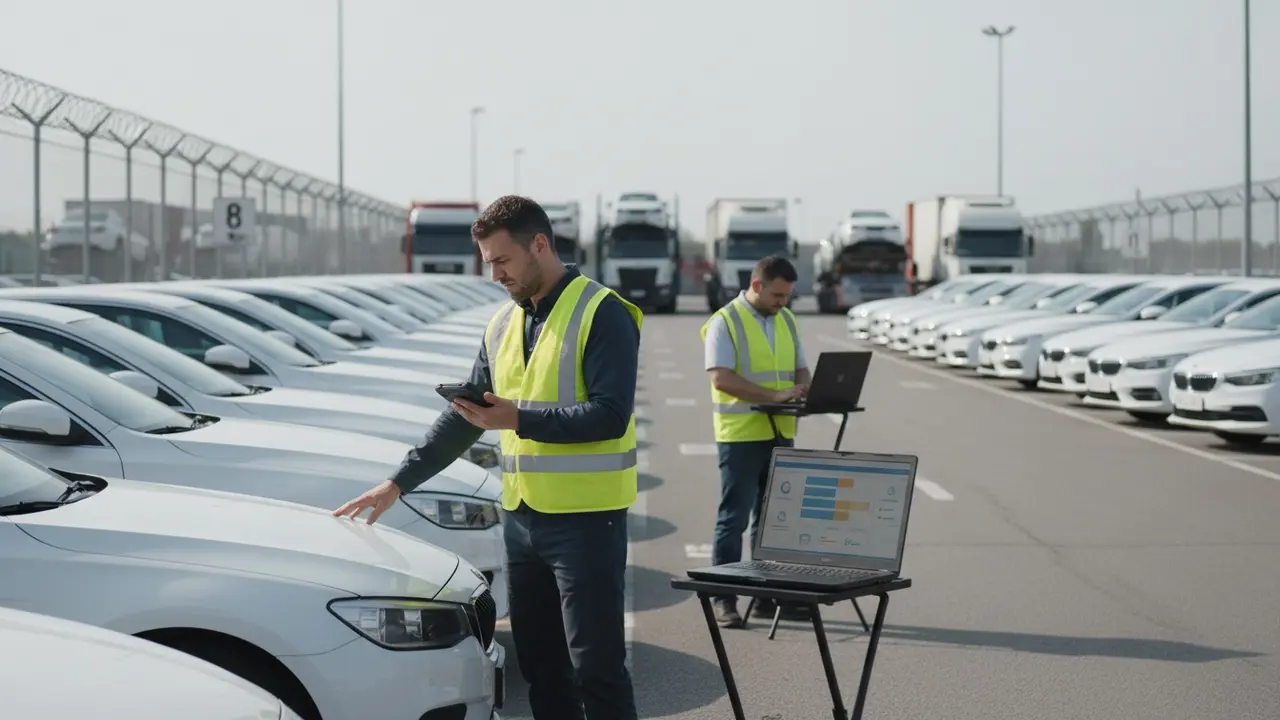
- Captura móvel guiada: Comece onde as inspeções são inevitáveis — mudanças de custódia em portões, descarga, carregamento, movimentações no pátio e entrega. Use dispositivos móveis para padronizar ângulos, fotos obrigatórias e metadados para que o registro do evento seja consistente entre operadores e locais. É aqui também que recomendamos incorporar o M-22 na captura, para que a terminologia e a codificação de danos sejam aplicadas quando a evidência é criada, e não reconstruída posteriormente de memória. A mudança mais importante voltada para o operador nesta fase é que a captura deve estar conectada à ação; nossa experiência é que os operadores sentem valor quando o Stream existe — tarefas, alertas, responsabilidade clara e rastreamento de encerramento — porque remove a ambiguidade sobre o que acontece após as fotos serem tiradas. É por isso que enfatizamos a camada de fluxo de trabalho entre a evidência e a ação durante a primeira fase.
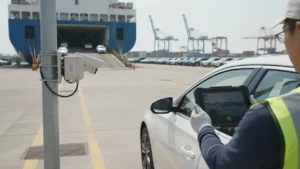
- Captura fixa: Uma vez que você tenha padrões de captura estáveis e fluxos de trabalho usados de forma consistente, a captura fixa torna-se um mecanismo de escala em vez de um experimento. Estações fixas podem aumentar a vazão em pontos de contato de alto volume, mas só entregam resultados consistentes quando a estrutura subjacente do evento de inspeção, as convenções de codificação e o tratamento de exceções já estão funcionando na forma móvel. Caso contrário, você automatiza a inconsistência.
- Integração: Integre após o registro do evento ter uma estrutura e ciclo de vida confiáveis. Nesta fase, as empresas sentem valor quando o Recover existe — sincronização pronta para sinistros nos sistemas, para que o mesmo evento não seja redigitado em ferramentas, e-mails e planilhas. A integração passa a ser sobre o mapeamento de campos estáveis, identificadores e status no TMS, sistemas de sinistros e operacionais que já governam o trabalho.
Nosso aprendizado prático em várias implementações é direto: se você apenas implementar inspeções, ainda se afogará no meio confuso. O gargalo operacional não é a captura de imagens; é a responsabilidade pelas exceções, o rastreamento do progresso e o encerramento. É por isso que tratamos as inspeções de ciclo fechado como o design mínimo viável para provar valor antes de escalar.
O que a TI precisa: segurança, um modelo de dados estável e uma trilha de auditoria
As equipes de TI raramente rejeitam a inovação por princípio. Elas rejeitam a incerteza: propriedade de dados pouco clara, controle de acesso fraco, regras de retenção ambíguas e integrações que não podem ser suportadas. Em uma implementação em fases, os requisitos de TI podem ser atendidos precocemente sem forçar uma construção de integração total no primeiro dia, desde que o design da plataforma antecipe a escala.
- Segurança e controle de acesso: Acesso baseado em funções alinhado às funções operacionais (equipe do terminal, supervisores da transportadora, qualidade da OEM, sinistros) e controles rigorosos sobre quem pode visualizar, exportar e editar evidências e registros de inspeção.
- Modelo de dados e identificadores: Um registro de evento bem definido que vincula o VIN, localização, carimbo de data/hora, parte sob custódia, tipo de inspeção e codificação de danos (incluindo M-22) para que o mesmo incidente possa ser referenciado consistentemente em todas as ferramentas. Sem identificadores e campos estáveis, as integrações amplificam a confusão em vez de eliminá-la.
- Trilha de auditoria e irretratabilidade: Um histórico claro do que foi capturado, quem capturou, o que mudou, quem aprovou ou rejeitou uma exceção e quando o caso foi encerrado. É isso que transforma a evidência em um registro operacional e comercial que pode resistir ao escrutínio interno e à resolução de disputas externas.
Quando a fase de integração começa, o objetivo deve ser remover a redigitação e os registros paralelos, especialmente em processos relacionados a sinistros, onde a transcrição manual é comum. Esboçamos as razões subjacentes em nosso artigo sobre por que os fluxos de trabalho de sinistros permanecem manuais, e os mesmos problemas normalmente surgem quando os programas de inspeção tentam se integrar antes que a estrutura do evento e a trilha de auditoria estejam maduras.
Evite novos silos: um único registro de evento em captura, fluxo de trabalho e recuperação
Implementações que começam com uma solução pontual estreita frequentemente criam um novo silo: uma ferramenta armazena imagens, outra armazena tarefas, outra armazena notas de sinistros e uma quarta torna-se o sistema de registro “oficial”. O resultado operacional é o trabalho duplicado: o mesmo incidente é reescrito várias vezes, o status é rastreado em vários lugares e as equipes discutem sobre qual registro é o atual.
Para evitar isso, projete em torno de um único evento de inspeção que percorre seu ciclo de vida: evidência capturada, dano classificado, atribuição de fluxo de trabalho, ações de resolução e saídas de recuperação/sinistro. Diferentes partes interessadas ainda podem precisar de diferentes visualizações e permissões, mas o registro subjacente deve permanecer unificado. Nossa perspectiva alinha-se com o princípio de uma única fonte da verdade (sem forçar uma única visualização) — um modelo de evento compartilhado que suporta múltiplos contextos operacionais sem fragmentar os dados.
Contexto de tecnologia e automação: por que a IA precisa de fluxo de trabalho e governança para escalar
A visão computacional pode padronizar o que é detectado e documentado, mas a automação só escala quando o processo circundante é projetado para consistência. Em nossas implementações, os critérios de sucesso técnico não se limitam à precisão do modelo; eles incluem se a captura guiada produz entradas repetíveis, se a codificação de danos é aplicada consistentemente na ponta e se os usuários a jusante podem confiar na trilha de auditoria e nos status.
É por isso que nossa abordagem vincula a inspeção baseada em IA a duas camadas operacionais: Stream para tratamento de exceções (tarefas, alertas, responsabilidade, rastreamento de encerramento) e Recover para sincronização empresarial e prontidão para sinistros. O valor da tecnologia é percebido quando a automação reduz a variação entre locais e operadores, cria um registro de evento confiável no momento da mudança de custódia e elimina a necessidade de reconstruir incidentes posteriormente a partir de evidências fragmentadas e e-mails. Simplificando: a IA acelera a captura, mas o fluxo de trabalho e a governança evitam que a organização recrie o mesmo registro de incidente quatro vezes.
Conclusão
A TI não bloqueou a implementação; o design da implementação o fez quando assumiu integração total, hardware fixo em todos os lugares e alinhamento universal de parceiros antes de provar o valor em inspeções inevitáveis de mudança de custódia. Uma implantação em fases — primeiro captura móvel guiada, depois captura fixa e, em seguida, integrações — permite que as equipes validem o registro do evento de inspeção, incorporem o M-22 precocemente e demonstrem o tratamento de exceções em ciclo fechado através do Stream antes de se comprometerem com a sincronização de nível empresarial através do Recover. Para OEMs, terminais, transportadoras e proprietários de tecnologia FVL, a lição prática é clara: comece onde as inspeções já acontecem, projete para o encerramento e não apenas para a captura, e escale para integrações somente após o fluxo de trabalho e o modelo de dados estarem estáveis o suficiente para eliminar o retrabalho em vez de automatizá-lo.