
Non serve l’intera catena per iniziare a ottenere visibilità
Non serve l’intera catena per iniziare a ottenere visibilità perché puoi partire dai nodi che controlli oggi, generare prove coerenti nei punti di cambio custodia ed espanderti partner dopo partner una volta stabilito uno standard. Nella logistica dei veicoli finiti, la visibilità raramente fallisce perché le persone non la vogliono; fallisce perché i programmi sono progettati come “tutte le parti, tutte le corsie, tutti i sistemi” fin dal primo giorno. Questo articolo spiega come iniziare con i passaggi di consegna controllati (piazzali, scali ferroviari ed eventi di trasporto), come progettare l’espansione usando standard e interoperabilità, e cosa misurare per primo affinché la visibilità si traduca in decisioni operative.
Spiegazione principale: la visibilità è un problema di implementazione, non di ecosistema
Le iniziative di visibilità vengono spesso presentate come una sfida di allineamento dell’ecosistema: OEM, LSP, ferrovie, porti, piazzali e vettori devono tutti adottare lo stesso processo contemporaneamente. Operativamente, questa impostazione crea un vicolo cieco. Più parti richiedi il primo giorno, più eccezioni, varianze nella formazione, nei dispositivi e nei processi introduci, prima ancora di avere una base stabile.
Nella nostra esperienza, si ottengono risultati più rapidi e affidabili trattando la visibilità come un problema di progettazione del flusso di lavoro del cambio di custodia. Inizia dove governi già il passaggio di consegna, standardizza il modo in cui le prove vengono acquisite e interpretate, e assicurati che il flusso di lavoro chiuda il cerchio dal rilevamento all’azione. Una volta che questi momenti sono coerenti, aggiungere partner diventa un lavoro di integrazione, non una negoziazione su cosa sia considerato “fatto bene”.
Mito: serve il coinvolgimento di ogni parte
Che serva il coinvolgimento di ogni parte è il presupposto comune quando i team equiparano la “visibilità” alla “copertura end-to-end”. In realtà, la maggior parte delle controversie e dei ritardi si innesca in punti di trasferimento specifici piuttosto che lungo l’intera tratta. Quando si verifica un reclamo, un ritardo o un evento di rilavorazione, la prima domanda di solito non è “cosa è successo in tutta la catena”, ma “cosa sapevamo al passaggio di consegna, e possiamo provarlo in modo coerente?”
Ecco perché l’adozione graduale tende a superare i programmi a tappeto. Le implementazioni controllate ti permettono di standardizzare le prove e le regole decisionali prima di esporre il processo a una maggiore variabilità tra partner e aree geografiche. Per una visione più approfondita di questa dinamica, vedi perché la progettazione di un rollout graduale guida l’adozione.
Realtà: inizia dove il volume e la proprietà sono chiari
Iniziare dove il volume e la proprietà sono chiari significa scegliere i nodi in cui controlli il flusso di lavoro fisico e puoi imporre un processo coerente di ispezione e gestione delle eccezioni. Questo di solito include i luoghi che gestisci (o amministri direttamente tramite contratti e SOP) e i momenti in cui la custodia cambia sotto la tua governance. Questo approccio crea valore immediato perché riduce prima di tutto l’ambiguità interna — i team smettono di discutere su “di chi sono le foto giuste” o “quale checklist è stata usata” — e ti fornisce un modello ripetibile da estendere all’esterno.
Nelle nostre implementazioni, abbiamo visto costantemente che non serve l’intero ecosistema allineato dal primo giorno. Inizia dove controlli i flussi di lavoro del cambio di custodia: all’interno di piazzali/depositi, negli scali ferroviari o durante gli eventi di ritiro/consegna dei vettori. Questi sono i punti in cui le prove hanno la massima influenza perché ancorano la responsabilità. Se vuoi saperne di più sul perché questi momenti contano, i passaggi di cambio custodia sono il luogo in cui la responsabilità si vince o si perde.
Quando standardizzi prima questi momenti, a livello operativo accadono due cose. Primo, il volume delle escalation interne diminuisce perché le prove diventano comparabili tra turni, siti e team, eliminando il “livello di discussione” prima ancora di coinvolgere i partner esterni. Secondo, l’espansione diventa più facile perché i nuovi partecipanti si collegano a uno standard esistente invece di inventare le proprie definizioni e pratiche fotografiche. Questa dinamica è strettamente connessa al costo nascosto del debito di prove, dove la mancanza di prove o la loro incoerenza si accumula in rilavorazioni a valle, cicli più lunghi e controversie evitabili.
Tre punti di partenza pratici: piazzale, scalo ferroviario e passaggio di consegna al trasporto
I punti di partenza più affidabili sono i nodi in cui puoi imporre la conformità del processo e dove le conseguenze delle eccezioni sono immediate.
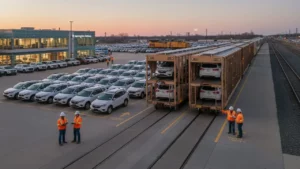
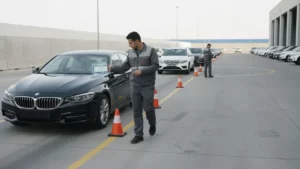
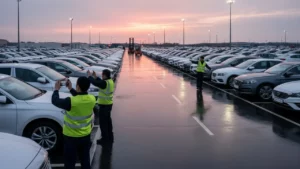
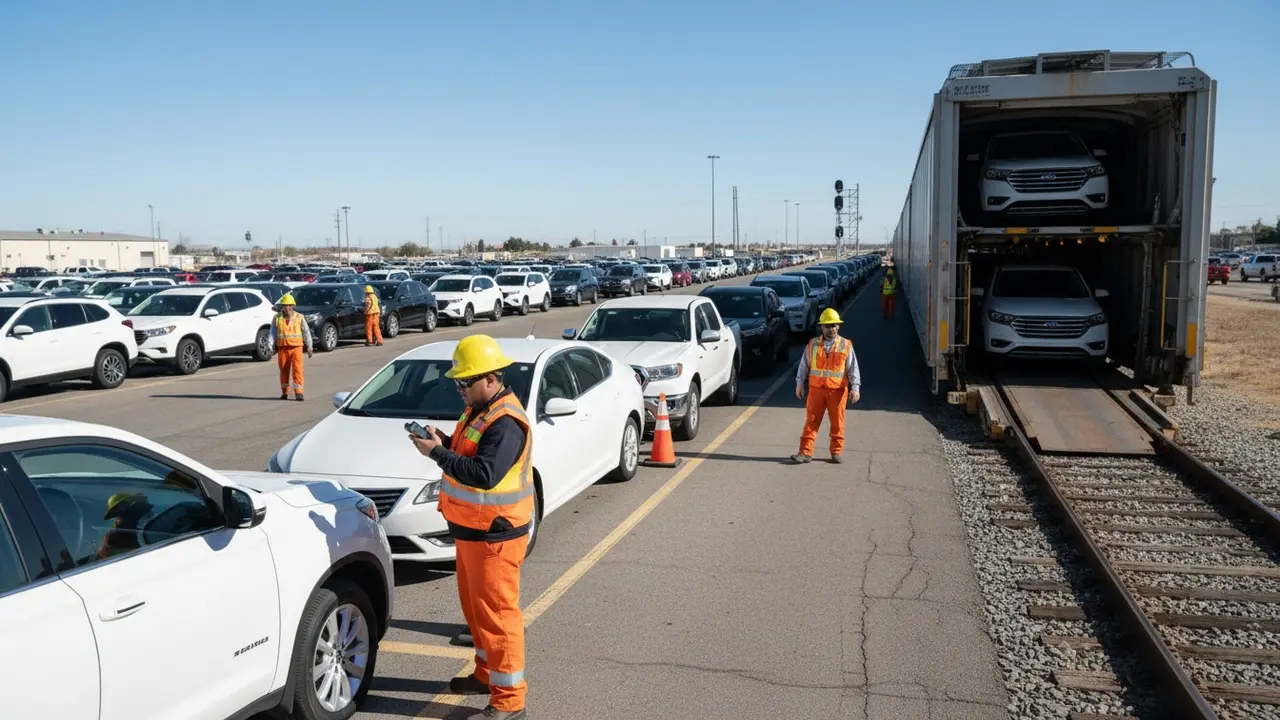
- Piazzale: Un piazzale o deposito che gestisci è l’ideale perché il flusso di lavoro è ripetibile: ricezione in entrata, spostamenti in stoccaggio, rilascio in uscita e controlli a campione periodici. Standardizzare le ispezioni qui stabilisce una condizione di base coerente e un “linguaggio” uniforme per le categorie di danno, la gravità e la posizione. Consente inoltre un triage rapido quando compaiono eccezioni durante lo stoccaggio o prima del rilascio.
- Scalo ferroviario: Uno scalo ferroviario gestito concentra volumi elevati in finestre prevedibili. Lo scarico e il ricarico ferroviario sono punti naturali di cambio custodia e spesso soffrono della pressione del tempo e di una qualità variabile della documentazione. L’acquisizione standardizzata e l’instradamento delle eccezioni riducono l’ambiguità su quando è apparso il danno e accelerano le decisioni su blocco, rilascio o escalation.
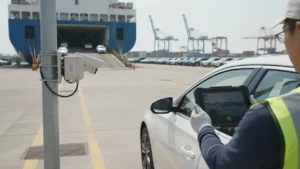
- Passaggio di consegna al trasporto: Il ritiro e la consegna da parte del vettore sono passaggi ad alto attrito perché si collocano tra molteplici incentivi operativi. Se governi il processo (anche se non possiedi il vettore), puoi rendere il passaggio deterministico: acquisizione coerente, criteri decisionali uniformi e percorsi di escalation costanti. Spesso è qui che la visibilità si traduce più direttamente in una riduzione delle controversie basate sul “lui dice, lei dice”.
Come ottenere valore immediato prima dell’adozione dei partner
Il valore immediato deriva dalla chiusura del cerchio nei nodi che controlli, non dalla raccolta di più foto. In pratica, ciò significa strutturare il flusso di lavoro in modo che le ispezioni inneschino rapidamente decisioni e azioni.
In genere vediamo l’impatto più rapido quando i team sequenziano il rollout attorno a tre capacità operative. Primo, usa Inspect dove controlli i passaggi di consegna per stabilire prove coerenti. Secondo, usa Stream per coordinare l’azione immediatamente in modo che le eccezioni non diventino ritardi; se le prove non creano compiti, assegnazioni e follow-up, diventano documentazione passiva. Se stai progettando quel livello operativo, trasformare le prove di ispezione in flussi di lavoro orientati all’azione è un riferimento pratico su come collegare l’acquisizione all’esecuzione. Terzo, usa Recover per abbreviare i reclami dove hai copertura, perché le prove di consegna standardizzate comprimono il botta e risposta solitamente richiesto per convalidare un reclamo e attribuire la responsabilità.
La chiave è che questi vantaggi non richiedono un’adozione universale. Richiedono il controllo del momento dell’acquisizione e il controllo di ciò che accade dopo.
Come progettare l’espansione usando standard e interoperabilità
L’espansione funziona quando tratti il tuo nodo iniziale come l’“implementazione di riferimento” per il resto della rete. L’obiettivo non è costringere i partner ad adottare immediatamente i tuoi strumenti; è rendere le tue prove e il tuo linguaggio sulle eccezioni interoperabili in modo che i partner possano connettersi senza dover rielaborare le proprie operazioni.
La progettazione per l’espansione include solitamente tre elementi.
- Una tassonomia dei danni e un protocollo di ispezione condivisi che rimangano stabili tra i siti, incluse soglie di gravità coerenti e mappatura di pannelli/zone.
- Un pacchetto di prove coerente per ogni evento di consegna, in modo che le parti esterne ricevano lo stesso set minimo di dati strutturati e immagini.
- Modelli di integrazione che consentano ai partner di connettersi a livello di dati (API, esportazioni, formati di eventi standard) mantenendo i propri strumenti operativi locali dove necessario.
Quando lo standard è facoltativo, le controversie diventano strutturali perché ogni parte porta le proprie definizioni e abitudini di documentazione. Ecco perché standardizzare le prove e il linguaggio previene le controversie non è un punto di governance astratto; è un prerequisito per scalare la visibilità nodo dopo nodo senza moltiplicare le eccezioni.
Man mano che i partner adottano il sistema, non stai chiedendo loro di inventare un nuovo flusso di lavoro. Stai chiedendo loro di collegarsi a un modello di consegna noto con input, output e regole decisionali chiare.
Cosa misurare per primo per dimostrare il valore e guidare il rollout
Le metriche iniziali dovrebbero riflettere i risultati operativi nei punti di consegna che controlli. Contare le ispezioni completate non basta; servono misure che dimostrino che il flusso di lavoro sta riducendo l’ambiguità, comprimendo i tempi decisionali e migliorando le prestazioni di recupero.
- Tempo di ciclo delle eccezioni dal rilevamento alla disposizione (rilascio, blocco, riparazione, escalation).
- Tasso di controversie ai passaggi di consegna, misurato come la quota di eventi che richiedono una riconciliazione manuale tra le parti.
- Tempo di ciclo dei reclami, dalla presentazione alla risoluzione, e la quota di reclami che richiedono rilavorazioni a causa di prove insufficienti. Per i team focalizzati sui reclami, ridurre il tempo di ciclo dei reclami con prove di consegna migliori collega direttamente queste metriche alla standardizzazione.
- Tasso di recupero sugli incidenti idonei, legato alla completezza e alla tempestività delle prove.
- Volume di reispezioni e rilavorazioni causate da acquisizioni incoerenti o confini di responsabilità poco chiari.
Queste misure sono efficaci perché traducono la visibilità in un controllo operativo concreto: meno escalation, decisioni più rapide e meno passaggi di consegna bloccati.
Contesto tecnologico e automazione: perché l’IA funziona meglio prima sui nodi controllati
L’ispezione basata sull’IA e la gestione delle eccezioni creano il massimo valore dove i processi sono ripetibili e dove il sistema può imporre la coerenza. Nei nodi controllati come piazzali, scali ferroviari e passaggi di consegna gestiti dai vettori, la configurazione delle immagini, il flusso di acquisizione e i criteri di accettazione possono essere standardizzati. Ciò migliora le prestazioni del modello in termini pratici: il sistema vede angolazioni e schemi di illuminazione comparabili, può applicare regole coerenti di classificazione dei danni e può produrre output strutturati abbastanza stabili da automatizzare l’instradamento a valle.
Altrettanto importante, l’automazione aiuta a ridurre la “varianza umana” al momento del passaggio di consegna. Quando le prove vengono acquisite e interpretate in modo coerente, le discussioni interne passano dall’interpretazione soggettiva alle decisioni operative. Quella coerenza è ciò che rende fattibile l’espansione ai partner: stai estendendo un flusso di lavoro collaudato e standardizzato piuttosto che scalare una serie di pratiche informali.
Infine, l’automazione dei reclami dipende da prove strutturate e comparabili. Senza di esse, i reclami rimangono manuali perché ogni caso diventa un esercizio di ricostruzione ad hoc. Se hai a che fare con questo vincolo, perché i reclami rimangono manuali senza prove standardizzate spiega perché le prove di consegna standard sono spesso il fattore limitante per l’automazione a valle.
Conclusione
Non serve l’adozione dell’intera catena per iniziare a ottenere visibilità; serve il controllo su specifici flussi di lavoro di cambio custodia e uno standard che produca prove coerenti. Inizia dove il volume e la proprietà sono chiari, dai priorità a piazzali, scali ferroviari e passaggi di consegna gestiti, e chiudi il cerchio in modo che le eccezioni diventino azioni anziché documentazione. Quando standardizzi i primi nodi, le controversie interne diminuiscono perché le prove diventano comparabili, e l’espansione esterna diventa più semplice perché i partner si collegano a un linguaggio e a un flusso di lavoro esistenti. Per gli stakeholder della logistica dei veicoli finiti, questo approccio trasforma la visibilità da un lungo progetto di ecosistema a un rollout controllato con risultati misurabili.