
Non è stata l’IT a bloccare il rollout, ma il design errato del rollout stesso
Spesso è il design errato del rollout, e non la resistenza dell’IT, a bloccare un deployment, perché cerca di risolvere ogni dipendenza (hardware, integrazioni, partner, cambio di processo) prima di dimostrare il valore nei punti di passaggio operativo dove le ispezioni avvengono già. Questo articolo spiega perché i programmi “big-bang” si fermano, come si presenta un modello di deployment graduale nella logistica dei veicoli finiti, cosa serve davvero all’IT per approvare e supportare la scalabilità e come evitare di creare nuovi silos di dati durante l’espansione dall’acquisizione ai workflow e alle integrazioni.
Spiegazione principale: dimostra il valore nei workflow prima, poi scala l’acquisizione e le integrazioni
I deployment rapidi nella logistica dei veicoli funzionano quando seguono la sequenza del lavoro: le prove vengono acquisite ai passaggi di responsabilità, le decisioni operative vengono prese nella “fase intermedia critica” delle eccezioni e solo allora le aziende hanno bisogno di una sincronizzazione strutturata del sistema di registrazione. Se provi a iniziare con il design dell’integrazione completa, l’installazione di hardware fisso e l’onboarding di più partner, il rollout presuppone un mondo perfetto: processi stabili, dati coerenti, stakeholder allineati e una maturità di governance immediata. In pratica, la via più veloce è iniziare con l’acquisizione guidata da mobile nei momenti di ispezione inevitabili, allegare la corretta codifica dei danni al momento dell’acquisizione e predisporre un livello di workflow in modo che le eccezioni vengano effettivamente gestite, portate avanti e chiuse. Una volta che il record dell’evento viene creato e chiuso in modo coerente, scalare verso l’acquisizione fissa e le integrazioni di sistema diventa un passaggio di implementazione piuttosto che una scommessa di trasformazione.
Perché il modello big-bang fallisce nei rollout della logistica dei veicoli finiti
I programmi big-bang falliscono perché raggruppano troppe incognite in un unico traguardo di “go-live”. Nella logistica dei veicoli finiti, le ispezioni si trovano all’intersezione di più parti (vettori, terminal, OEM, aree di stoccaggio, last-mile) e più sistemi (TMS, sistemi di piazzale, strumenti per i reclami, gestione documentale). Quando un rollout richiede nuovo hardware ovunque, che ogni partner segua nuove SOP e che ogni sistema scambi eventi perfettamente strutturati dal primo giorno, il progetto diventa fragile: una singola dipendenza mancante arresta il progresso e un solo percorso di eccezione al di fuori del design mina la fiducia nell’output.
Abbiamo osservato ripetutamente che “l’IT ci ha bloccato” diventa la spiegazione di comodo dopo che un programma si arena. I progetti che sono falliti erano quelli che cercavano di integrare tutto subito: integrazione big-bang, nuovo hardware in ogni sito, ogni partner a bordo e ogni workflow ridefinito prima che chiunque avesse dimostrato risultati tangibili nelle ispezioni di passaggio di responsabilità che non possono essere saltate. Se vuoi un inquadramento simile di questo approccio, leggi il nostro pezzo su come iniziare a ottenere visibilità senza integrare l’intera catena.
Il modello big-bang crea anche quello che le operazioni sperimentano in seguito come debito di prove: qualità di acquisizione incoerente, record di eventi frammentati e contesto mancante che rendono la risoluzione a valle e il lavoro sui reclami più lenti invece che più veloci. Per i lettori che cercano una vista in stile checklist, abbiamo anche documentato le modalità di fallimento comuni nell’adozione delle ispezioni AI che compaiono frequentemente in questi design “tutto in una volta”.
Modello graduale: acquisizione guidata da mobile → acquisizione fissa → integrazione
Un modello graduale funziona perché allinea l’investimento e la complessità con ciò che è già stato convalidato nelle operazioni quotidiane. L’obiettivo non è ritardare l’integrazione a tempo indeterminato, ma renderla prevedibile standardizzando prima il record dell’evento e dimostrando che le eccezioni possono essere chiuse con una responsabilità chiara.
- Acquisizione guidata da mobile: Inizia dove le ispezioni sono inevitabili: passaggi di responsabilità ai cancelli, scarico, carico, spostamenti nel piazzale e consegna. Usa il mobile per standardizzare angolazioni, scatti richiesti e metadati in modo che il record dell’evento sia coerente tra operatori e siti. Questo è anche il punto in cui consigliamo di integrare M-22 all’acquisizione, in modo che la terminologia e la codifica dei danni siano applicate quando la prova viene creata, non ricostruita in seguito a memoria. Il cambiamento più importante per l’operatore in questa fase è che l’acquisizione deve essere collegata all’azione; la nostra esperienza è che gli operatori percepiscono il valore quando esiste Stream — attività, avvisi, responsabilità chiara e tracciamento della chiusura — perché elimina l’ambiguità su ciò che accade dopo lo scatto delle foto. Ecco perché enfatizziamo il livello di workflow tra prova e azione durante la prima fase.
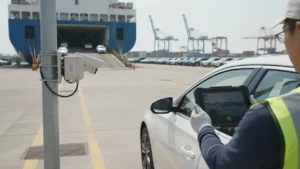
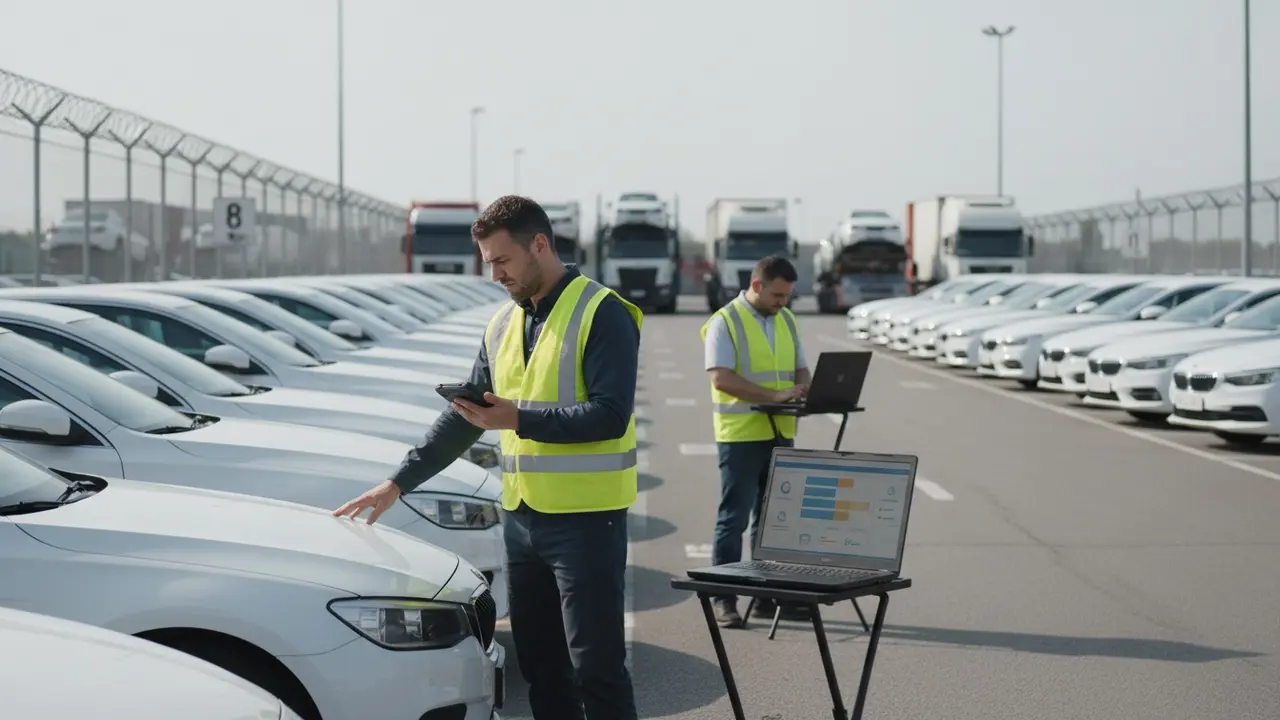
- Acquisizione fissa: Una volta che hai standard di acquisizione stabili e workflow utilizzati in modo coerente, l’acquisizione fissa diventa un meccanismo di scalabilità piuttosto che un esperimento. Le stazioni fisse possono aumentare la produttività nei punti di contatto ad alto volume, ma forniscono risultati coerenti solo quando la struttura dell’evento di ispezione sottostante, le convenzioni di codifica e la gestione delle eccezioni funzionano già in modalità mobile. Altrimenti, automatizzi l’incoerenza.
- Integrazione: Integra dopo che il record dell’evento ha una struttura e un ciclo di vita affidabili. In questa fase, le aziende percepiscono il valore quando esiste Recover — sincronizzazione pronta per il reclamo nei sistemi, in modo che lo stesso evento non venga riscritto tra strumenti, e-mail e fogli di calcolo. L’integrazione diventa quindi una questione di mappatura di campi, identificatori e stati stabili nel TMS, nei reclami e nei sistemi operativi che già governano il lavoro.
Il nostro apprendimento pratico tra i vari deployment è diretto: se distribuisci solo le ispezioni, annegherai comunque nella fase intermedia critica. Il collo di bottiglia operativo non è l’acquisizione delle immagini; è la responsabilità delle eccezioni, il tracciamento dei progressi e la chiusura. Ecco perché consideriamo le ispezioni a ciclo chiuso come il design minimo vitale per dimostrare il valore prima di scalare.
Cosa serve all’IT: sicurezza, un modello di dati stabile e un audit trail
I team IT raramente rifiutano l’innovazione per principio. Rifiutano l’incertezza: proprietà dei dati non chiara, controllo degli accessi debole, regole di conservazione ambigue e integrazioni che non possono essere supportate. In un rollout graduale, i requisiti IT possono essere soddisfatti precocemente senza forzare una build di integrazione completa il primo giorno, a condizione che il design della piattaforma anticipi la scalabilità.
- Sicurezza e controllo degli accessi: Accesso basato sui ruoli allineato ai ruoli operativi (personale del terminal, supervisori dei vettori, qualità OEM, reclami) e controlli rigorosi su chi può visualizzare, esportare e modificare le prove e i record delle ispezioni.
- Modello di dati e identificatori: Un record dell’evento ben definito che colleghi VIN, posizione, timestamp, parte responsabile, tipo di ispezione e codifica del danno (incluso M-22) in modo che lo stesso incidente possa essere referenziato coerentemente tra gli strumenti. Senza identificatori e campi stabili, le integrazioni amplificano la confusione invece di eliminarla.
- Audit trail e non ripudiabilità: Una cronologia chiara di cosa è stato acquisito, chi lo ha acquisito, cosa è cambiato, chi ha approvato o rifiutato un’eccezione e quando il caso è stato chiuso. Questo è ciò che trasforma una prova in un record operativo e commerciale in grado di resistere ai controlli interni e alla risoluzione delle controversie esterne.
Quando inizia la fase di integrazione, l’obiettivo dovrebbe essere quello di eliminare il reinserimento dei dati e i record paralleli, specialmente nei processi relativi ai reclami dove la trascrizione manuale è comune. Delineiamo le ragioni sottostanti nel nostro articolo su perché i workflow dei reclami rimangono manuali, e gli stessi problemi emergono tipicamente quando i programmi di ispezione cercano di integrarsi prima che la struttura dell’evento e l’audit trail siano maturi.
Evita nuovi silos: un unico record dell’evento tra acquisizione, workflow e recupero
I rollout che iniziano con una soluzione puntuale ristretta spesso creano un nuovo silo: uno strumento memorizza le immagini, un altro le attività, un altro le note sui reclami e un quarto diventa il sistema di registrazione “ufficiale”. Il risultato operativo è un lavoro duplicato: lo stesso incidente viene riscritto più volte, lo stato viene tracciato in più posti e i team discutono su quale record sia quello aggiornato.
Per evitare questo, progetta attorno a un singolo evento di ispezione che percorre il suo ciclo di vita: prove acquisite, danno classificato, assegnazione del workflow, azioni di risoluzione e output di recupero/reclamo. Diversi stakeholder possono comunque aver bisogno di viste e permessi differenti, ma il record sottostante deve rimanere unificato. La nostra prospettiva si allinea al principio di un’unica fonte di verità (senza forzare un’unica vista) — un modello di evento condiviso che supporta molteplici contesti operativi senza frammentare i dati.
Contesto tecnologico e automazione: perché l’AI ha bisogno di workflow e governance per scalare
La computer vision può standardizzare ciò che viene rilevato e documentato, ma l’automazione scala solo quando il processo circostante è progettato per la coerenza. Nei nostri deployment, i criteri di successo tecnico non si limitano all’accuratezza del modello; includono se l’acquisizione guidata produce input ripetibili, se la codifica dei danni è applicata coerentemente all’edge e se gli utenti a valle possono fidarsi dell’audit trail e degli stati.
Ecco perché il nostro approccio collega l’ispezione guidata dall’AI a due livelli operativi: Stream per la gestione delle eccezioni (attività, avvisi, responsabilità, tracciamento della chiusura) e Recover per la sincronizzazione aziendale e la preparazione ai reclami. Il valore tecnologico si realizza quando l’automazione riduce la varianza tra siti e operatori, crea un record dell’evento affidabile al momento del passaggio di responsabilità ed elimina la necessità di ricostruire gli incidenti in seguito da prove frammentate ed e-mail. In parole povere: l’AI accelera l’acquisizione, ma il workflow e la governance impediscono all’organizzazione di ricreare lo stesso record dell’incidente quattro volte.
Conclusione
L’IT non ha bloccato il rollout; lo ha fatto il design del rollout quando ha ipotizzato un’integrazione completa, hardware fisso ovunque e allineamento universale dei partner prima di dimostrare il valore nelle ispezioni inevitabili di passaggio di responsabilità. Un deployment graduale — prima acquisizione guidata da mobile, poi acquisizione fissa, quindi integrazioni — consente ai team di convalidare il record dell’evento di ispezione, integrare M-22 precocemente e dimostrare la gestione delle eccezioni a ciclo chiuso tramite Stream prima di impegnarsi nella sincronizzazione di livello enterprise tramite Recover. Per OEM, terminal, vettori e proprietari di tecnologie FVL, la lezione pratica è chiara: inizia dove le ispezioni avvengono già, progetta per la chiusura e non solo per l’acquisizione, e scala verso le integrazioni solo dopo che il workflow e il modello di dati sono abbastanza stabili da eliminare il lavoro superfluo invece di automatizzarlo.